Programuję od prawie dziesięciu lat i muszę przyznać: przed AI łatwiej było wyczuć, ile się umie, a ile nie. Junior wiedział, że nie wie. Senior miał blizny po produkcji i spokój w głosie. Granice doświadczenia były czytelne, bo były widoczne w kodzie, w rozmowie i w sposobie myślenia.
Od czasów AI te granice się rozmyły. Każdy "korzysta z AI", każdy oddaje podobnie wyglądający kod, a deklaracja nie kosztuje nic. Jak dziś wyznaczyć poziom doświadczenia, czyli seniority, skoro linijki kodu pisze model, a człowiek kieruje procesem?
Na to pytanie szukam odpowiedzi w praktyce: pracuję z agentami kodującymi na co dzień, od małych automatyzacji po wdrożenia produkcyjne. I tu wchodzi temat tego wpisu.
mega.dev i Assessment jako bonus 🎓
MEGA to czterotygodniowy program (start 26 października), w którym uczą Kent C. Dodds, Angie Jones, John Lindquist i Theo Browne, a architekturą całego przedsięwzięcia zajął się Adam Gospodarczyk (overment), ten od AI_Devs, który nauczył AI tysiące polskich programistów. Za projektem stoją BRAVE Grześka Roga i Badass Courses Joela Hooksa. Live, na którym to wszystko zobaczyłem, współprowadzili właśnie Adam z Grześkiem. W skrócie uczą tam pracy z agentami: konkretne, wąsko zdefiniowane zadania, krótkie rozmowy, wiedza trafia do plików, które przeżywają każdą sesję, a skalę robi liczba agentów, nie długość czatu. Zastanawiam się nad udziałem, a w międzyczasie skorzystałem z czegoś, co uważam za bonus tego ekosystemu: MEGA Assessment.
To nie quiz i nie syntetyczny test z podpowiedzianą odpowiedzią. Assessment przeskanował moją prawdziwą historię pracy z agentami: co agent dostawał na wejściu, co odsyłał, jak zadawano korekty i co z tej pracy zostało. Zamiast deklaracji "korzystam z AI" dostajesz pomiar tego, jak naprawdę układasz współpracę.
Jest w tym jedna rzecz, która przesądziła moją ciekawość. Pierwszy raz spotkałem się z testem tego typu, a przeszukałem sieć dokładnie pod tym kątem: nie znalazłem niczego podobnego, co pracowałoby na Twoich autentycznych danych, czyli na prawdziwej historii pracy. Wszystko, co znalazłem, mierzyło w wygodnych warunkach: piaskownica, zmyślone zadanie, demo-projekt ustawiony pod ocenę, czy coś w ten deseń. Ani razu spotkanie z prawdziwą historią pracy. Tymczasem MEGA wchodzi w to, co już się wydarzyło, i ocenia nawyki tam, gdzie miały konsekwencje. To zupełnie inna jakość dowodu.
Moje liczby 📊
- 77 dni pracy z agentami (25 czerwca - 9 września 2026),
- 95 sesji,
- 172 realne epizody, czyli kompletne jednostki pracy,
- zmierzonych 23 z 24 cech sposobu pracy.
Próbka szeroka: 48 epizodów dokumentacyjnych, 36 z analityki i diagnostyki, 24 wdrożenia funkcji, 15 researchu. Średnio 2-3 konkretne zadania dziennie przez niemal trzy miesiące.
Dylemat objętości 🧮
Dużo czy mało? Programiści lubią liczyć linijki kodu, a tu linijek nie ma i to jest celowe. Objętość przestała cokolwiek znaczyć, bo kod pisze model. Człowiek projektuje proces: rozkłada problem, ustawia granice, weryfikuje wyniki i pilnuje, żeby decyzje nie ginęły w rozmowie. Dlatego Assessment mierzy sposób pracy, a nie wynik klawiatury.
Moja karta: The Memory Lock 🔒
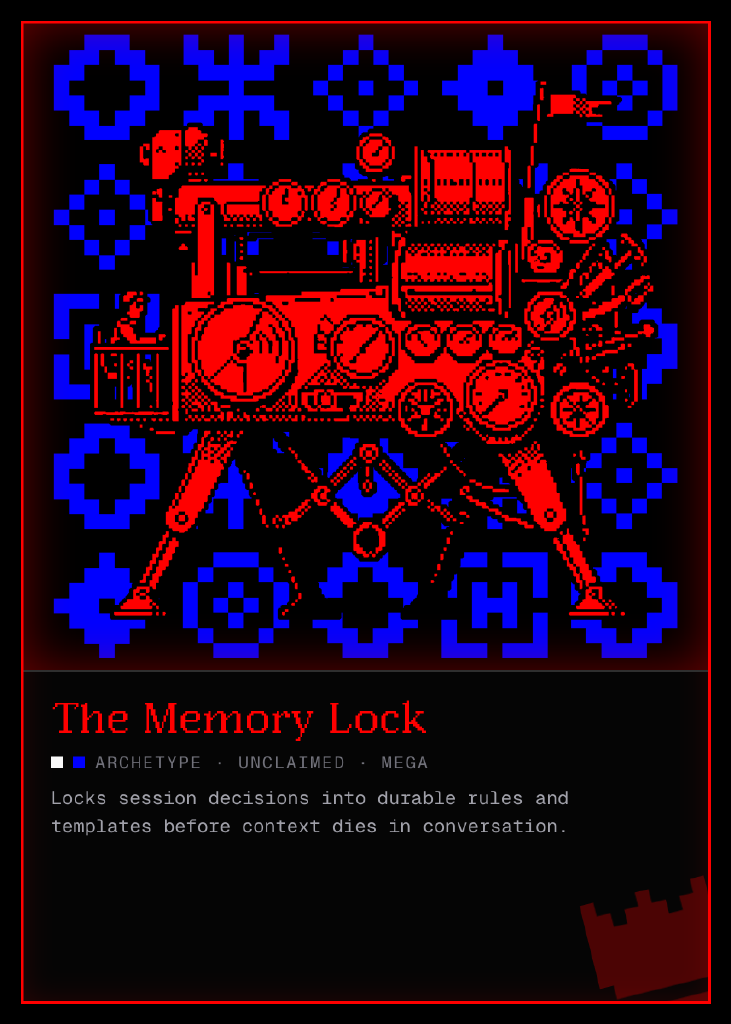
Locks session decisions into durable rules and templates before context dies in conversation.
Czyli: zamykam decyzje z sesji w trwałych regułach i szablonach, zanim kontekst umrze w rozmowie. W praktyce to najważniejsza rzecz, jaką zrobiłem w tym kwartale dla własnej wydajności.
Co wyszło jako najsilniejsze wzorce 💪
Ułamki typu 72/72 to nie licznik sukcesów. To konsekwencja: za każdym razem, gdy dana sytuacja wystąpiła, nawyk zadziałał.
- 44/44 - decyzje od razu lądują w regułach projektu i szablonach, nie giną w czacie.
- 72/72 - kontekst kotwiczony w artefaktach (plikach, specyfikacjach, raportach), nie w opowieści z pamięci.
- 68/68 - precyzyjny feedback z dowodem przy korektach, nie "popraw to".
- 72/74 - dowody w punkcie decyzji, zanim decyzja zapadnie.
- 8/8 - nauka z błędów wraca jako reguła na przyszłość.
Druga strona medalu 🪞
Nie byłoby uczciwie pokazać tylko passę. Raport wylicza 147 korekt i 101 ponowień instrukcji. Krótkie pętle poprawek zamiast marzenia "odpal i odejdź".
Najcenniejsza lekcja z całego pomiaru: mierzalne kryteria akceptacji PRZED uruchomieniem agenta (15/48, najjaśniejsza dziura w moim zestawie). Twarde asercje, nienaruszalne granice i test, który agent sam odpala, zanim uzna zadanie za skończone. Drugi obszar do dociągnięcia to inicjatywna delegacja (8/22): badanie, przegląd czy weryfikację często warto oddać agentowi, zamiast robić samemu.
Czym pracuję 🛠️
Na co dzień moim głównym agentem jest Droid od Factory (ten sam, który pomaga mi utrzymywać skladmuzyczny.pl, portfolio i harnessy MCP). IMO po prostu najlepszy :) Obok niego: agentic workflows, serwery MCP, własne skille i zasada "kontekst w plikach, nie w pamięci rozmowy". Assessment to potwierdził liczbami, a nie opiniami.
Punkt bazowy, nie medal 🎯
Żeby było jasne: to dowód procesowy, nie ranking. Porównań do innych tu nikt nie da.
Ale sedno widzę w jednym zdaniu: taki test jest dziś użytecznym sposobem pokazania, jak się pracuje z narzędziami AI. Na live usłyszeliśmy, że assessment pokazuje, na jakim jesteście etapie drogi do MegaDev. Moim zdaniem idzie o krok dalej: taki wynik nadaje się do CV albo podania o pracę jako dowód, jak pracujesz, a nie jak deklarujesz. Deklarację każdy wpisze w 5 sekund i nic ona nie dowodzi. Danych z własnej historii wpisać się nie da, one kosztują miesiące realnej pracy. Różnica między deklaracją a dowodem to dziś różnica między szumem a sygnałem.
Za 2-3 miesiące powtórzę pomiar i porównam wynik, zwłaszcza kryteria akceptacji i inicjatywną delegację. Zobaczymy, czy nawyki faktycznie się przesunęły.
Pełny wynik: mega.dev/you/LtnBnIFFFjxBmArIkxRiewfbud9_4QbwKvDB5XjPkXw
Dzięki Adamowi i Grześkowi za live i za narzędzie, które pokazuje, jakim programistą się jest naprawdę, a nie jakim się deklaruje.